Một phân tích chuyên sâu về Đồ thị Tri thức Cá nhân (Personal Knowledge Graph) của Apple cho thấy chính xác những gì chiếc máy Mac và hệ thống Apple Intelligence biết về bạn cũng như cuộc sống hàng ngày của bạn.
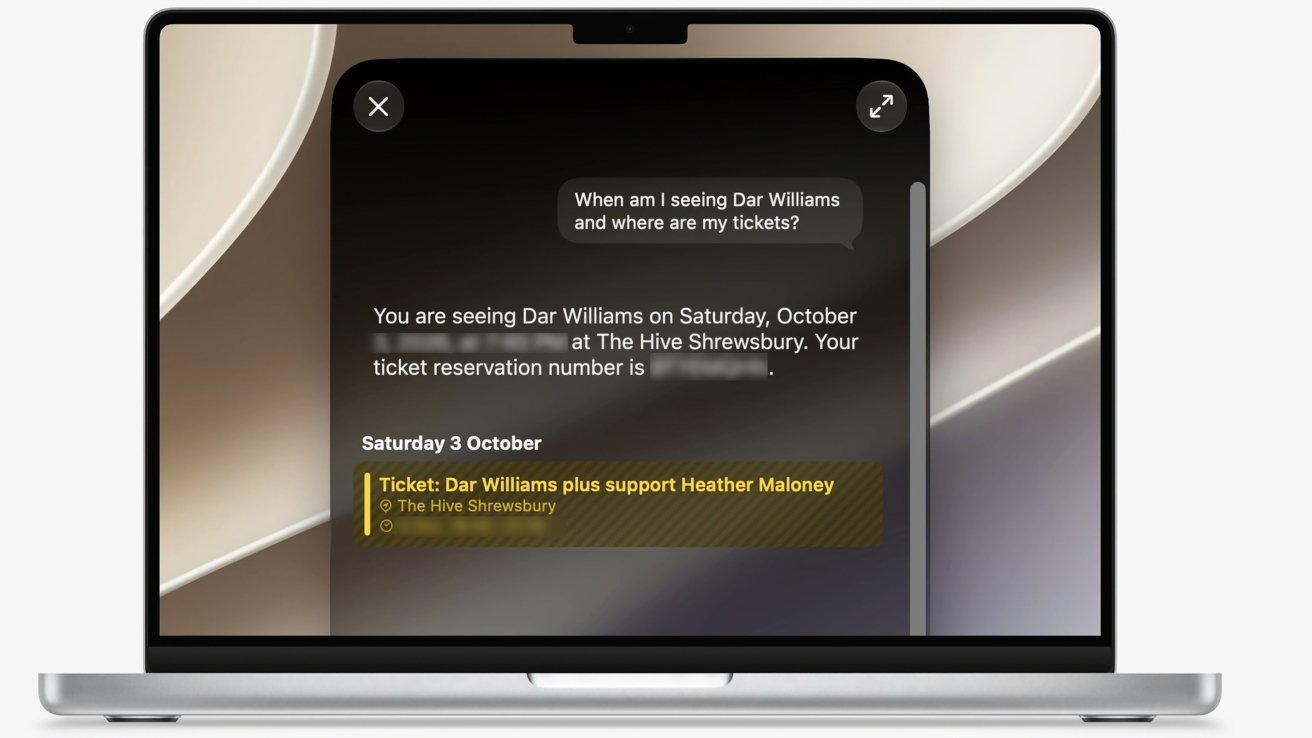
Bản nâng cấp lên Siri AI đã bổ sung khả năng thấu hiểu ngữ cảnh cá nhân vào hệ thống Apple Intelligence. Bằng cách trích xuất thông tin từ tin nhắn, email và hình ảnh, Siri có thể đưa ra câu trả lời cho các truy vấn có chứa yếu tố ngữ cảnh cá nhân, chẳng hạn như biết tên mẹ của bạn dựa vào một lịch trình chuyến bay trong email.
Tuy nhiên, thực tế Apple đã âm thầm tổng hợp dữ liệu về người dùng của mình trên thiết bị từ lâu hơn thế rất nhiều, khi hệ điều hành macOS 13 đã bắt đầu thực hiện việc này từ năm 2022. Trong một báo cáo phân tích kỹ thuật của các nhà nghiên cứu bảo mật tại tổ chức Eighth Rank, quá trình khởi tạo Đồ thị Tri thức Cá nhân trong macOS đã được hé lộ chi tiết, bao gồm cả các loại dữ liệu mà nó tổng hợp và lưu giữ trên chiếc máy Mac của bạn.
Một cặp tiến trình chạy ngầm (A pair of daemons)
Quá trình này bắt đầu bằng một cặp tiến trình chạy ngầm (daemons) mà Apple tích hợp sẵn trong macOS, được dùng để biên dịch đồ thị tri thức. Tuy nhiên, Apple không cung cấp nhiều thông tin tài liệu về chúng, ngoài cái tên knowledgeconstructiond và một lời giải thích ngắn gọn rằng nó phân tích nội dung trên thiết bị và tạo ra một đồ thị tri thức.
Các tiến trình chạy ngầm này lưu trữ kết quả làm việc trong thư mục Library/IntelligencePlatform, nơi chứa tới 51 cơ sở dữ liệu SQLite. Mặc dù được lưu dưới dạng văn bản thuần (plaintext), chúng được đặt trong một vùng an toàn được bảo vệ bởi cơ chế cấp quyền truy cập toàn bộ ổ đĩa TCC (Full Disk Access).
Một cơ sở dữ liệu mà các nhà nghiên cứu thấy đặc biệt thú vị là tệp graph.db, sử dụng 181 lớp thực thể (entity classes) và 278 vị từ quan hệ (predicates), trong đó mỗi hàng dữ liệu bao gồm một chủ thể (subject), một đối tượng (object) và một vị từ (predicate).
Chủ thể là một thực thể dưới một dạng nào đó, chẳng hạn như một con người hoặc một ứng dụng, còn các đối tượng là một giá trị thuần túy như tên gọi hoặc ngày tháng. Vị từ cho biết loại mối quan hệ mà cơ sở dữ liệu tin rằng đang tồn tại giữa chủ thể và đối tượng đó.

Danh sách các thực thể trải rộng từ những khái niệm như "con người", "nhóm người" và "sinh vật" cho đến các chủ đề cụ thể như "nhân vật hoạt động nghệ thuật", "tổ chức thể thao" và "đảng phái chính trị". Các vị từ bao gồm "đây là loại vật thể gì", "thể loại", "có tôn giáo là", "các chủ đề mà một người quan tâm", và "cụm nhận diện khuôn mặt của một người".
Phần lớn công việc của các tiến trình chạy ngầm là lấp đầy cơ sở dữ liệu bằng những mối quan hệ này theo thời gian. Các cơ sở dữ liệu khác bao gồm một nhật ký giao tiếp thu thập thông tin về vị trí và sự di chuyển của bạn, cùng một danh sách dài các tín hiệu trạng thái thiết bị.
Ngoài ra còn có một luồng dữ liệu mang tên ContextualUnderstanding.PhysicalSocial, dường như là danh sách những người và thông tin liên lạc mà người dùng đã từng ở gần về mặt vật lý vào một thời điểm nào đó. Tuy nhiên, các nhà nghiên cứu nhận thấy luồng dữ liệu này hoàn toàn chưa được ghi nhận thông tin nào.
Gia đình và cơ chế xóa dữ liệu (Families and deletion)
Các tiến trình chạy ngầm sẽ sao chép trực tiếp các điểm dữ liệu từ các nguồn trên máy và đưa ra các phán đoán dựa trên những gì nó tìm thấy. Điều này bao gồm cả việc suy luận xem một điểm dữ liệu mới có liên quan đến các điểm dữ liệu hiện có hay không, chẳng hạn như liệu một cái tên vừa xuất hiện có phải là của một người đã có sẵn trong đồ thị tri thức hay không.
Hệ thống có thể sử dụng rất nhiều yếu tố khác nhau để đưa ra phán quyết. Để xác định ai là thành viên gia đình của người dùng, các mô hình được cho là đã xem xét tới 144 đặc trưng chủ yếu thuộc về hành vi, kết hợp với phân tích từ ứng dụng Ảnh (Photos) về những người thường xuyên xuất hiện chung trong các bức ảnh với bạn.
Mỗi hàng dữ liệu đều được gắn một điểm số độ tin cậy (confidence score) nằm trong khoảng từ 0 đến 1.
Các mô hình và hệ thống khác cũng phức tạp không kém, nhưng đồng thời cũng có một sự phức tạp nhất định trong cách nó xử lý dữ liệu đã bị xóa.
Việc xóa một tham chiếu nào đó — chẳng hạn như xóa một liên hệ trong Danh bạ — không làm nó biến mất ngay lập tức khỏi cơ sở dữ liệu. Đồ thị trực tiếp chính (main live graph) có khả năng "quên", khi các liên hệ đã xóa sẽ dần biến mất do không còn được hệ thống tái suy luận trong các đợt bảo trì định kỳ.
Tuy nhiên, một bảng thứ hai mang tên expired_stable_graph được duy trì song song cùng lúc với đồ thị trực tiếp. Nó chứa các hàng dữ liệu đã bị thu hồi, kèm theo đầy đủ điểm số độ tin cậy và điểm mối quan hệ, và dữ liệu trong bảng này dường như chỉ được dọn dẹp sạch sau khoảng 48 giờ.
Hệ quả là một kết luận được rút ra từ các mô hình vẫn có thể tồn tại lâu hơn cả thông tin gốc trên thiết bị vốn đã giúp tạo ra kết luận đó.
Cực kỳ chi tiết, nhưng được lưu trữ cục bộ hoàn toàn (Detailed, but locally stored)
Phân tích này cho thấy có một kho dữ liệu khổng lồ đang được lưu trữ trên một chiếc máy Mac với mức độ chi tiết đáng kinh ngạc. Trong quá trình nghiên cứu thử nghiệm, hệ thống có thể xác định được trong hộ gia đình có một đứa trẻ cùng độ tuổi của bé, nhà trẻ mà bé đang theo học và các số điện thoại liên quan.
Nó cũng có khả năng xác định một gia đình sẽ ở đâu, vào thời gian nào, trong bao lâu, cũng như những ai sẽ có mặt tại địa điểm đó vào thời điểm đó.
Từ góc độ quyền riêng tư, việc có một lượng thông tin lớn ở mức độ chi tiết đến như vậy để phục vụ các tính năng như ngữ cảnh cá nhân của Siri có thể khiến nhiều người cảm thấy lo ngại.
Nhưng đồng thời, hãy luôn nhớ rằng đây hoàn toàn là dữ liệu được lưu trữ và phân tích cục bộ ngay trên chiếc máy Mac của bạn. Nó bảo mật và riêng tư hơn rất nhiều so với những gì các công ty AI khác đang thực hiện trên đám mây, bởi dữ liệu này không hề rời khỏi thiết bị của bạn.